Introduction#
生成对象(Object):对图像,视频,蛋白质等数据类型可视为向量,即 z ∈ R d z \in \mathbb{R}^d z ∈ R d
生成(Generation):从数据分布中采样,z ∼ p d a t a z \sim p_{data} z ∼ p d a t a
数据集(Dataset):服从数据分布的有限样本,z 1 , . . . , z N ∼ p d a t a z_1, ...,z_N \sim p_{data} z 1 , ... , z N ∼ p d a t a
条件生成(Conditional Generation):从条件分布中采样,z ∼ p d a t a ( ⋅ ∣ y ) z \sim p_{data}(\cdot \mid y) z ∼ p d a t a ( ⋅ ∣ y )
目标:训练生成模型,将初始分布(p init p_{\text{init}} p init p data p_{\text{data}} p data
Flow and Diffusion Models#
通过模拟常微分方程(Ordinary Differential Equations, ODEs)和随机微分方程(Stochastic Differential Equations, SDEs)可以实现从初始分布到数据分布的转换,分别对应Flow Model和Diffusion Model
Flow Models#
Flow Model可以由ODE来描述,即
X 0 ∼ p init ▹ random init d d t X t = u t θ ( X t ) ▹ ODE Goal: X 1 ∼ p data ⇔ ψ 1 θ ( X 0 ) ∼ p data X_0 \sim p_{\text{init}} \quad \triangleright \text{random init}\\
\frac{d}{dt}X_t=u_t^\theta(X_t) \quad \triangleright \text{ODE} \\
\text{Goal: } X_1 \sim p_{\text{data}} \Leftrightarrow \psi_{1}^{\theta}(X_0) \sim p_{\text{data}} X 0 ∼ p init ▹ random init d t d X t = u t θ ( X t ) ▹ ODE Goal: X 1 ∼ p data ⇔ ψ 1 θ ( X 0 ) ∼ p data 其中向量场 u t θ : R d × [ 0 , 1 ] → R d u_t^\theta: \mathbb{R}^d\times[0,1] \rightarrow \mathbb{R}^d u t θ : R d × [ 0 , 1 ] → R d θ \theta θ ψ t θ \psi^\theta_t ψ t θ u t θ u_t^\theta u t θ
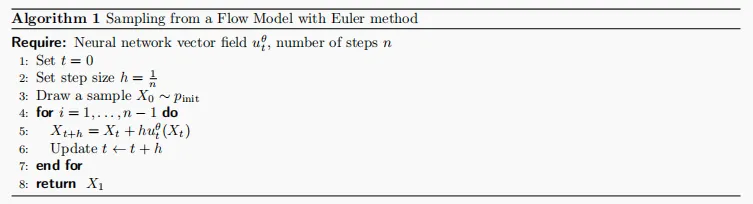
通过使用Euler算法,可以模拟ODE计算出Flow,实现从Flow Model中采样
Diffusion Models#
Diffusion Model可以由SDEs描述,如下所示(由于其随机性SDEs不使用微分表示形式)
d X t = u t θ ( X t ) d t + σ t d W t ▹ SDE X 0 ∼ p i n i t ▹ random initialization Goal: X 1 ∼ p data dX_t = u_t^\theta(X_t)dt +\sigma_tdW_t \quad \triangleright \text{SDE} \\
X_0 \sim p_{init} \quad \triangleright \text{random initialization} \\
\text{Goal: } X_1 \sim p_{\text{data}} d X t = u t θ ( X t ) d t + σ t d W t ▹ SDE X 0 ∼ p ini t ▹ random initialization Goal: X 1 ∼ p data 其中 σ t ≥ 0 \sigma_t \geq 0 σ t ≥ 0 W t W_t W t
可以看出Diffusion Model是Flow Model的一个拓展,当σ t = 0 \sigma_t = 0 σ t = 0
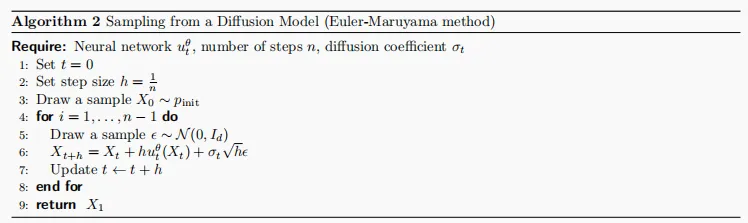
同样的,可以使用以下算法实现从Diffusion Model中采样
Training Target and Train Loss#
对于Flow Model和Diffusion Model
X 0 ∼ p init , d X t = u t θ ( X t ) d t (Flow model) X 0 ∼ p init , d X t = u t θ ( X t ) d t + σ t d W t (Diffusion model) \begin{align*}
X_0 \sim p_{\text{init}},\quad dX_t &= u_t^\theta(X_t) dt & \text{(Flow model)} \\
X_0 \sim p_{\text{init}},\quad dX_t &= u_t^\theta(X_t) dt + \sigma_t dW_t & \text{(Diffusion model)}
\end{align*} X 0 ∼ p init , d X t X 0 ∼ p init , d X t = u t θ ( X t ) d t = u t θ ( X t ) d t + σ t d W t (Flow model) (Diffusion model) 训练可以通过最小化以下损失实现
L ( θ ) = ∥ u t θ ( x ) − u t target ( x ) ⏟ training target ∥ 2 \mathcal{L}(\theta) = \left\| u_t^\theta(x) - \underbrace{u_t^{\text{target}}(x)}_{\text{training target}} \right\|^2 L ( θ ) = u t θ ( x ) − training target u t target ( x ) 2 u t θ u_t^\theta u t θ u t target ( x ) u_t^{\text{target}}(x) u t target ( x ) L ( θ ) \mathcal{L}(\theta) L ( θ ) L ( θ ) \mathcal{L}(\theta) L ( θ ) u t target ( x ) u_t^{\text{target}}(x) u t target ( x )
Probability Path#
Probability Path是从初始分布到目标数据分布的渐进插值(gradual interpolation),分为条件概率路径(conditional probability path)和边缘概率路径(marginal probability path),分别为p t ( ⋅ ∣ z ) p_t(\cdot \mid z) p t ( ⋅ ∣ z ) p t ( ⋅ ) p_t(\cdot) p t ( ⋅ )
p 0 ( ⋅ ∣ z ) = p init , p 1 ( ⋅ ∣ z ) = δ z for all z ∈ R d p_0(\cdot \mid z) = p_{\text{init}}, \quad p_1(\cdot \mid z) = \delta_z \quad \text{for all } z \in \mathbb{R}^d p 0 ( ⋅ ∣ z ) = p init , p 1 ( ⋅ ∣ z ) = δ z for all z ∈ R d p t ( ⋅ ) p_t(\cdot) p t ( ⋅ )
z ∼ p data , x ∼ p t ( ⋅ ∣ z ) ⟹ x ∼ p t ▹ sampling from marginal path p t ( x ) = ∫ p t ( x ∣ z ) p data ( z ) d z ▹ density of marginal path p 0 = p init and p 1 = p data ▹ noise-data interpolation \begin{align*}
&z \sim p_{\text{data}},\ x \sim p_t(\cdot \mid z) \implies x \sim p_t &\triangleright \text{sampling from marginal path} \\
&p_t(x) = \int p_t(x \mid z) p_{\text{data}}(z)dz &\triangleright \text{density of marginal path} \\
&p_0 = p_{\text{init}} \quad \text{and} \quad p_1 = p_{\text{data}}
&\triangleright \text{noise-data interpolation} \\
\end{align*} z ∼ p data , x ∼ p t ( ⋅ ∣ z ) ⟹ x ∼ p t p t ( x ) = ∫ p t ( x ∣ z ) p data ( z ) d z p 0 = p init and p 1 = p data ▹ sampling from marginal path ▹ density of marginal path ▹ noise-data interpolation Training Target for Flow Model#
对于z ∈ R d ∼ p d a t a z \in \mathbb{R^d} \sim p_{data} z ∈ R d ∼ p d a t a u t t a r g e t ( ⋅ ∣ z ) u_t^{target}(\cdot \mid z) u t t a r g e t ( ⋅ ∣ z ) p t ( ⋅ ∣ z ) p_t(\cdot \mid z) p t ( ⋅ ∣ z )
X 0 ∼ p init , d d t X t = u t target ( X t ∣ z ) ⇒ X t ∼ p t ( ⋅ ∣ z ) ( 0 ≤ t ≤ 1 ) X_0 \sim p_{\text{init}},\quad \frac{\mathrm{d}}{\mathrm{d}t}X_t = u_t^{\text{target}}(X_t|z) \quad \Rightarrow \quad X_t \sim p_t(\cdot|z) \quad (0 \leq t \leq 1) X 0 ∼ p init , d t d X t = u t target ( X t ∣ z ) ⇒ X t ∼ p t ( ⋅ ∣ z ) ( 0 ≤ t ≤ 1 ) 则u t t a r g e t ( x ) u_t^{target}(x) u t t a r g e t ( x )
u t target ( x ) = ∫ u t target ( x ∣ z ) p t ( x ∣ z ) p data ( z ) p t ( x ) d z u_t^{\text{target}}(x) = \int u_t^{\text{target}}(x|z) \frac{p_t(x|z)p_{\text{data}}(z)}{p_t(x)} \,\mathrm{d}z u t target ( x ) = ∫ u t target ( x ∣ z ) p t ( x ) p t ( x ∣ z ) p data ( z ) d z 且满足:
X 0 ∼ p init , d d t X t = u t target ( X t ) ⇒ X t ∼ p t ( 0 ≤ t ≤ 1 ) X_0 \sim p_{\text{init}},\quad \frac{\mathrm{d}}{\mathrm{d}t}X_t = u_t^{\text{target}}(X_t) \quad \Rightarrow \quad X_t \sim p_t \quad (0 \leq t \leq 1) X 0 ∼ p init , d t d X t = u t target ( X t ) ⇒ X t ∼ p t ( 0 ≤ t ≤ 1 ) 其中X 1 ∼ p d a t a X_1 \sim p_{data} X 1 ∼ p d a t a
这可以由Continuity Equation 证明
Continuity Equation
对于向量场u t t a r g e t u_t^{target} u t t a r g e t X 0 ∼ p i n i t X_0 \sim p_{init} X 0 ∼ p ini t X t ∼ p t X_t \sim p_t X t ∼ p t 0 ≤ t ≤ 1 0 \leq t \leq 1 0 ≤ t ≤ 1
∂ t p t ( x ) = − d i v ( p t u t target ) ( x ) for all x ∈ R d , 0 ≤ t ≤ 1 \partial_t p_t(x) = -\mathrm{div}(p_t u_t^{\text{target}})(x) \quad \text{for all } x \in \mathbb{R}^d, 0 \leq t \leq 1 ∂ t p t ( x ) = − div ( p t u t target ) ( x ) for all x ∈ R d , 0 ≤ t ≤ 1 其中∂ t p t ( x ) = d d t p t ( x ) \partial_t p_t(x) = \frac{\mathrm{d}}{\mathrm{d}t} p_t(x) ∂ t p t ( x ) = d t d p t ( x ) d i v ( v t ) ( x ) = ∑ i = 1 d ∂ ∂ x i v t ( x ) \mathrm{div}(v_t)(x) = \sum_{i=1}^d \frac{\partial}{\partial x_i} v_t(x) div ( v t ) ( x ) = ∑ i = 1 d ∂ x i ∂ v t ( x )
Training Target for Diffusion Model#
同样的,对于Diffusion Model,可以构建u t t a r g e t u_t^{target} u t t a r g e t X t ∼ p t ( 0 ≤ t ≤ 1 ) X_t \sim p_t \quad (0 \leq t \leq 1) X t ∼ p t ( 0 ≤ t ≤ 1 )
X 0 ∼ p init , d X t = [ u t target ( X t ) + σ t 2 2 ∇ log p t ( X t ) ] d t + σ t d W t ⇒ X t ∼ p t ( 0 ≤ t ≤ 1 ) \begin{align*}
&X_0 \sim p_{\text{init}}, \quad \mathrm{d}X_t = \left[ u_t^{\text{target}}(X_t) + \frac{\sigma_t^2}{2} \nabla \log p_t(X_t) \right] \mathrm{d}t + \sigma_t \mathrm{d}W_t \\
&\Rightarrow X_t \sim p_t \quad (0 \leq t \leq 1)
\end{align*} X 0 ∼ p init , d X t = [ u t target ( X t ) + 2 σ t 2 ∇ log p t ( X t ) ] d t + σ t d W t ⇒ X t ∼ p t ( 0 ≤ t ≤ 1 ) 并且将p t ( x ) , u t t a r g e t p_t(x), u_t^{target} p t ( x ) , u t t a r g e t p t ( x ∣ z ) , u t t a r g e t ( x ∣ z ) p_t(x\mid z), u_t^{target}(x \mid z) p t ( x ∣ z ) , u t t a r g e t ( x ∣ z )
其中,∇ log p t ( x ) \nabla \log p_t(x) ∇ log p t ( x ) ∇ log p t ( x ∣ z ) \nabla \log p_t(x \mid z) ∇ log p t ( x ∣ z )
∇ log p t ( x ) = ∇ p t ( x ) p t ( x ) = ∇ ∫ p t ( x ∣ z ) p data ( z ) d z p t ( x ) = ∫ ∇ p t ( x ∣ z ) p data ( z ) d z p t ( x ) = ∫ ∇ log p t ( x ∣ z ) p t ( x ∣ z ) p data ( z ) p t ( x ) d z \nabla \log p_t(x) = \frac{\nabla p_t(x)}{p_t(x)} = \frac{\nabla \int p_t(x|z) p_{\text{data}}(z) \,\mathrm{d}z}{p_t(x)} = \frac{\int \nabla p_t(x|z) p_{\text{data}}(z) \,\mathrm{d}z}{p_t(x)} = \int \nabla \log p_t(x|z) \frac{p_t(x|z) p_{\text{data}}(z)}{p_t(x)} \,\mathrm{d}z ∇ log p t ( x ) = p t ( x ) ∇ p t ( x ) = p t ( x ) ∇ ∫ p t ( x ∣ z ) p data ( z ) d z = p t ( x ) ∫ ∇ p t ( x ∣ z ) p data ( z ) d z = ∫ ∇ log p t ( x ∣ z ) p t ( x ) p t ( x ∣ z ) p data ( z ) d z 这可以由Fokker-Planck Equation证明
Fokker-Planck Equation
对于X 0 ∼ p init , d X t = u t ( X t ) d t + σ t d W t X_0 \sim p_{\text{init}}, \quad \mathrm{d}X_t = u_t(X_t)\,\mathrm{d}t + \sigma_t\,\mathrm{d}W_t X 0 ∼ p init , d X t = u t ( X t ) d t + σ t d W t X t ∼ p t X_t \sim p_t X t ∼ p t
∂ t p t ( x ) = − d i v ( p t u t ) ( x ) + σ t 2 2 Δ p t ( x ) for all x ∈ R d , 0 ≤ t ≤ 1 \partial_t p_t(x) = -\mathrm{div}(p_t u_t)(x) + \frac{\sigma_t^2}{2} \Delta p_t(x) \quad \text{for all } x \in \mathbb{R}^d, 0 \leq t \leq 1 ∂ t p t ( x ) = − div ( p t u t ) ( x ) + 2 σ t 2 Δ p t ( x ) for all x ∈ R d , 0 ≤ t ≤ 1 其中,Δ w t ( x ) = ∑ i = 1 d ∂ 2 ∂ x i 2 w t ( x ) = d i v ( ∇ w t ) ( x ) \Delta w_t(x) = \sum_{i=1}^d \frac{\partial^2}{\partial x_i^2} w_t(x) = \mathrm{div}(\nabla w_t)(x) Δ w t ( x ) = ∑ i = 1 d ∂ x i 2 ∂ 2 w t ( x ) = div ( ∇ w t ) ( x )
Remark Langevin dynamics
当p t = p p_t=p p t = p
d X t = σ t 2 2 ∇ log p ( X t ) d t + σ t d W t \mathrm{d}X_t = \frac{\sigma_t^2}{2} \nabla \log p(X_t)\,\mathrm{d}t + \sigma_t\,\mathrm{d}W_t d X t = 2 σ t 2 ∇ log p ( X t ) d t + σ t d W t 此时 X 0 ∼ p ⇒ X t ∼ p ( t ≥ 0 ) X_0 \sim p \quad \Rightarrow \quad X_t \sim p \quad (t \geq 0) X 0 ∼ p ⇒ X t ∼ p ( t ≥ 0 )
Gaussian probability path#
设噪声调度α t , β t \alpha_t, \beta_t α t , β t α 0 = β 1 = 0 , α 1 = β 0 = 1 \alpha_0=\beta_1=0, \alpha_1=\beta_0=1 α 0 = β 1 = 0 , α 1 = β 0 = 1
p t ( ⋅ ∣ z ) = N ( α t z , β t 2 I d ) p_t(\cdot|z) = \mathcal{N}(\alpha_t z, \beta_t^2 I_d) p t ( ⋅ ∣ z ) = N ( α t z , β t 2 I d ) 其满足 p 0 ( ⋅ ∣ z ) = N ( α 0 z , β 0 2 I d ) = N ( 0 , I d ) , and p 1 ( ⋅ ∣ z ) = N ( α 1 z , β 1 2 I d ) = δ z p_0(\cdot|z) = \mathcal{N}(\alpha_0 z, \beta_0^2 I_d) = \mathcal{N}(0, I_d), \quad \text{and} \quad p_1(\cdot|z) = \mathcal{N}(\alpha_1 z, \beta_1^2 I_d) = \delta_z p 0 ( ⋅ ∣ z ) = N ( α 0 z , β 0 2 I d ) = N ( 0 , I d ) , and p 1 ( ⋅ ∣ z ) = N ( α 1 z , β 1 2 I d ) = δ z
则从其marginal path中采样可以通过以下方法得到
z ∼ p data , ϵ ∼ p init = N ( 0 , I d ) ⇒ x = α t z + β t ϵ ∼ p t z \sim p_{\text{data}},\ \epsilon \sim p_{\text{init}} = \mathcal{N}(0, I_d) \Rightarrow x = \alpha_t z + \beta_t \epsilon \sim p_t z ∼ p data , ϵ ∼ p init = N ( 0 , I d ) ⇒ x = α t z + β t ϵ ∼ p t 基于Gaussian probability path的conditional Gaussian vector field可以计算得到
u t target ( x ∣ z ) = ( α ˙ t − β ˙ t β t α t ) z + β ˙ t β t x u_t^{\text{target}}(x|z) = \left( \dot{\alpha}_t - \frac{\dot{\beta}_t}{\beta_t} \alpha_t \right) z + \frac{\dot{\beta}_t}{\beta_t} x u t target ( x ∣ z ) = ( α ˙ t − β t β ˙ t α t ) z + β t β ˙ t x 其中α ˙ t = ∂ t α t \dot{\alpha}_t = \partial_t \alpha_t α ˙ t = ∂ t α t β ˙ t = ∂ t β t \dot{\beta}_t = \partial_t \beta_t β ˙ t = ∂ t β t
同样的可以得到其marginal score function为
∇ log p t ( x ∣ z ) = − x − α t z β t 2 \nabla \log p_t(x|z) = -\frac{x - \alpha_t z}{\beta_t^2} ∇ log p t ( x ∣ z ) = − β t 2 x − α t z Flow Matching#
对于Flow Model,定义flow matching loss为
L FM ( θ ) = E t ∼ Unif , x ∼ p t [ ∥ u t θ ( x ) − u t target ( x ) ∥ 2 ] = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ u t θ ( x ) − u t target ( x ) ∥ 2 ] \begin{align*}
\mathcal{L}_{\text{FM}}(\theta) &= \mathbb{E}_{t \sim \text{Unif}, x \sim p_t}[\|u_t^\theta(x) - u_t^{\text{target}}(x)\|^2] \\
&= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t(\cdot|z)}[\|u_t^\theta(x) - u_t^{\text{target}}(x)\|^2]
\end{align*} L FM ( θ ) = E t ∼ Unif , x ∼ p t [ ∥ u t θ ( x ) − u t target ( x ) ∥ 2 ] = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ u t θ ( x ) − u t target ( x ) ∥ 2 ]
z ∼ p data , x ∼ p t ( ⋅ ∣ z ) ⟹ x ∼ p t z \sim p_{\text{data}},\ x \sim p_t(\cdot \mid z) \implies x \sim p_t z ∼ p data , x ∼ p t ( ⋅ ∣ z ) ⟹ x ∼ p t
定义conditional flow matching loss为
L CFM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ u t θ ( x ) − u t target ( x ∣ z ) ∥ 2 ] \mathcal{L}_{\text{CFM}}(\theta) = \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t(\cdot|z)}[\|u_t^\theta(x) - u_t^{\text{target}}(x|z)\|^2] L CFM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ u t θ ( x ) − u t target ( x ∣ z ) ∥ 2 ] 其中u t target ( x ∣ z ) u_t^{\text{target}}(x|z) u t target ( x ∣ z )
可以证明,
L FM ( θ ) = L CFM ( θ ) + C \mathcal{L}_{\text{FM}}(\theta) = \mathcal{L}_{\text{CFM}}(\theta) + C L FM ( θ ) = L CFM ( θ ) + C 即
∇ θ L FM ( θ ) = ∇ θ L CFM ( θ ) \nabla_\theta \mathcal{L}_{\text{FM}}(\theta) = \nabla_\theta \mathcal{L}_{\text{CFM}}(\theta) ∇ θ L FM ( θ ) = ∇ θ L CFM ( θ ) 因此优化L CFM \mathcal{L}_{\text{CFM}} L CFM L FM \mathcal{L}_{\text{FM}} L FM L CFM \mathcal{L}_{\text{CFM}} L CFM
Flow Matching for Gaussian Conditional Probability Paths
对于Gaussian Probability Path,有
ϵ ∼ N ( 0 , I d ) ⇒ x t = α t z + β t ϵ ∼ N ( α t z , β t 2 I d ) = p t ( ⋅ ∣ z ) \epsilon \sim \mathcal{N}(0, I_d) \quad \Rightarrow \quad x_t = \alpha_t z + \beta_t \epsilon \sim \mathcal{N}(\alpha_t z, \beta_t^2 I_d) = p_t(\cdot|z) ϵ ∼ N ( 0 , I d ) ⇒ x t = α t z + β t ϵ ∼ N ( α t z , β t 2 I d ) = p t ( ⋅ ∣ z ) u t t a r g e t ( x ∣ z ) = ( α ˙ t − β ˙ t β t α t ) z + β ˙ t β t x u_t^{\mathrm{target}}(x|z)=\left(\dot{\alpha}_t-\frac{\dot{\beta}_t}{\beta_t}\alpha_t\right)z+\frac{\dot{\beta}_t}{\beta_t}x u t target ( x ∣ z ) = ( α ˙ t − β t β ˙ t α t ) z + β t β ˙ t x L C F M ( θ ) = E t ∼ U n i f , z ∼ p d a t a , x ∼ N ( α t z , β t 2 I d ) [ ∥ u t θ ( x ) − ( α ˙ t − β ˙ t β t α t ) z − β ˙ t β t x ∥ 2 ] = ( i ) E t ∼ U n i f , z ∼ p d a t a , ϵ ∼ N ( 0 , I d ) [ ∥ u t θ ( α t z + β t ϵ ) − ( α ˙ t z + β ˙ t ϵ ) ∥ 2 ] \begin{gathered}
\mathcal{L}_{\mathrm{CFM}}(\theta)=\mathbb{E}_{t\sim\mathrm{Unif},z\sim p_{\mathrm{data}},x\sim\mathcal{N}(\alpha_{t}z,\beta_{t}^{2}I_{d})}[\|u_{t}^{\theta}(x)-\left(\dot{\alpha}_{t}-\frac{\dot{\beta}_{t}}{\beta_{t}}\alpha_{t}\right)z-\frac{\dot{\beta}_{t}}{\beta_{t}}x\|^{2}] \\
\overset{(i)}{\operatorname*{=}}\mathbb{E}_{t\sim\mathrm{Unif},z\sim p_{\mathrm{data}},\epsilon\sim\mathcal{N}(0,I_{d})}[\|u_{t}^{\theta}(\alpha_{t}z+\beta_{t}\epsilon)-(\dot{\alpha}_{t}z+\dot{\beta}_{t}\epsilon)\|^{2}]
\end{gathered} L CFM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ N ( α t z , β t 2 I d ) [ ∥ u t θ ( x ) − ( α ˙ t − β t β ˙ t α t ) z − β t β ˙ t x ∥ 2 ] = ( i ) E t ∼ Unif , z ∼ p data , ϵ ∼ N ( 0 , I d ) [ ∥ u t θ ( α t z + β t ϵ ) − ( α ˙ t z + β ˙ t ϵ ) ∥ 2 ] 特别的,对于α t = t \alpha_t=t α t = t β t = 1 − t \beta_t=1-t β t = 1 − t
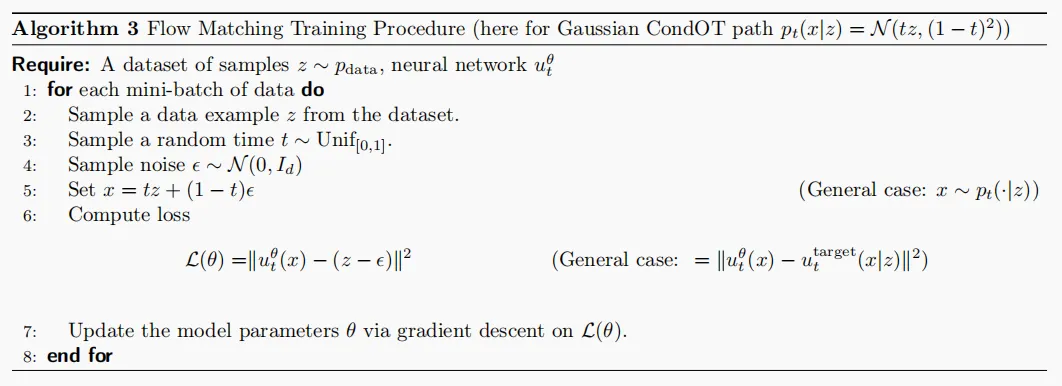
p t ( x ∣ z ) = N ( t z , ( 1 − t ) 2 ) p_{t}(x|z)=\mathcal{N}(tz,(1-t)^{2}) p t ( x ∣ z ) = N ( t z , ( 1 − t ) 2 ) L c f m ( θ ) = E t ∼ U n i f , z ∼ p d a t a , ϵ ∼ N ( 0 , I d ) [ ∥ u t θ ( t z + ( 1 − t ) ϵ ) − ( z − ϵ ) ∥ 2 ] \mathcal{L}_{\mathrm{cfm}}(\theta)=\mathbb{E}_{t\sim\mathrm{Unif},z\sim p_{\mathrm{data}},\epsilon\sim\mathcal{N}(0,I_{d})}[\|u_{t}^{\theta}(tz+(1-t)\epsilon)-(z-\epsilon)\|^{2}] L cfm ( θ ) = E t ∼ Unif , z ∼ p data , ϵ ∼ N ( 0 , I d ) [ ∥ u t θ ( t z + ( 1 − t ) ϵ ) − ( z − ϵ ) ∥ 2 ] 称之为(Gaussian) CondOT probability path ,训练过程如下所示
Score Matching#
对于Diffusion Models,由于u t t a r g e t u_t^{target} u t t a r g e t score network σ t 2 : R d × [ 0 , 1 ] → R \sigma_t^2 : \mathbb{R}^d \times [0, 1] \to \mathbb{R} σ t 2 : R d × [ 0 , 1 ] → R
L SM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ s t θ ( x ) − ∇ log p t ( x ) ∥ 2 ] ▹ score matching loss L CSM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ s t θ ( x ) − ∇ log p t ( x ∣ z ) ∥ 2 ] ▹ conditional score matching loss \begin{align*}
\mathcal{L}_{\text{SM}}(\theta) &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t(\cdot|z)}[\|s_t^\theta(x) - \nabla \log p_t(x)\|^2] \quad \triangleright \text{ score matching loss} \\
\mathcal{L}_{\text{CSM}}(\theta) &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t(\cdot|z)}[\|s_t^\theta(x) - \nabla \log p_t(x|z)\|^2] \quad \triangleright \text{ conditional score matching loss}
\end{align*} L SM ( θ ) L CSM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ s t θ ( x ) − ∇ log p t ( x ) ∥ 2 ] ▹ score matching loss = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ s t θ ( x ) − ∇ log p t ( x ∣ z ) ∥ 2 ] ▹ conditional score matching loss 同样的,虽然∇ log p t ( x ) \nabla \log p_t(x) ∇ log p t ( x ) ∇ log p t ( x ∣ z ) \nabla \log p_t(x \mid z) ∇ log p t ( x ∣ z )
L SM ( θ ) = L SFM ( θ ) + C ⟹ ∇ θ L SM ( θ ) = ∇ θ L CSM ( θ ) \begin{align*}
&\mathcal{L}_{\text{SM}}(\theta) = \mathcal{L}_{\text{SFM}}(\theta) + C \\
&\implies \nabla_\theta \mathcal{L}_{\text{SM}}(\theta) = \nabla_\theta \mathcal{L}_{\text{CSM}}(\theta)
\end{align*} L SM ( θ ) = L SFM ( θ ) + C ⟹ ∇ θ L SM ( θ ) = ∇ θ L CSM ( θ ) 因此,优化L CSM ( θ ) \mathcal{L}_{\text{CSM}}(\theta) L CSM ( θ )
X 0 ∼ p init , d X t = [ u t θ ( X t ) + σ t 2 2 s t θ ( X t ) ] d t + σ t d W t ⟹ X 1 ∼ p d a t a X_0 \sim p_{\text{init}}, \quad \mathrm{d}X_t = \left[ u_t^\theta(X_t) + \frac{\sigma_t^2}{2} s_t^\theta(X_t) \right] \mathrm{d}t + \sigma_t \mathrm{d}W_t \implies X_1 \sim p_{data} X 0 ∼ p init , d X t = [ u t θ ( X t ) + 2 σ t 2 s t θ ( X t ) ] d t + σ t d W t ⟹ X 1 ∼ p d a t a 其中,尽管理论上对任意σ t ≥ 0 \sigma_t \geq 0 σ t ≥ 0 σ t \sigma_t σ t u t θ u_t^\theta u t θ u t θ u_t^\theta u t θ s t θ s_t^\theta s t θ
Denoising Diffusion Models: Score Matching for Gaussian Probability Paths
对于Gaussian Probability Paths,有
∇ log p t ( x ∣ z ) = − x − α t z β t 2 \nabla \log p_t(x|z) = -\frac{x - \alpha_t z}{\beta_t^2} ∇ log p t ( x ∣ z ) = − β t 2 x − α t z 则
L CSM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ s t θ ( x ) + x − α t z β t 2 ∥ 2 ] = E t ∼ Unif , z ∼ p data , ϵ ∼ N ( 0 , I d ) [ ∥ s t θ ( α t z + β t ϵ ) + ϵ β t ∥ 2 ] = E t ∼ Unif , z ∼ p data , ϵ ∼ N ( 0 , I d ) [ 1 β t 2 ∥ β t s t θ ( α t z + β t ϵ ) + ϵ ∥ 2 ] \begin{align*}
\mathcal{L}_{\text{CSM}}(\theta) &= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, x \sim p_t(\cdot|z)}\left[\left\|s_t^\theta(x) + \frac{x - \alpha_t z}{\beta_t^2}\right\|^2\right] \\
&= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N}(0, I_d)}\left[\left\|s_t^\theta(\alpha_t z + \beta_t \epsilon) + \frac{\epsilon}{\beta_t}\right\|^2\right] \\
&= \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N}(0, I_d)}\left[\frac{1}{\beta_t^2} \left\|\beta_t s_t^\theta(\alpha_t z + \beta_t \epsilon) + \epsilon\right\|^2\right]
\end{align*} L CSM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ s t θ ( x ) + β t 2 x − α t z 2 ] = E t ∼ Unif , z ∼ p data , ϵ ∼ N ( 0 , I d ) [ s t θ ( α t z + β t ϵ ) + β t ϵ 2 ] = E t ∼ Unif , z ∼ p data , ϵ ∼ N ( 0 , I d ) [ β t 2 1 β t s t θ ( α t z + β t ϵ ) + ϵ 2 ] 由于1 β t 2 \frac{1}{\beta^2_t} β t 2 1 β t \beta_t β t 1 β t 2 \frac{1}{\beta^2_t} β t 2 1 s t θ s^\theta_t s t θ ϵ t θ \epsilon_t^\theta ϵ t θ
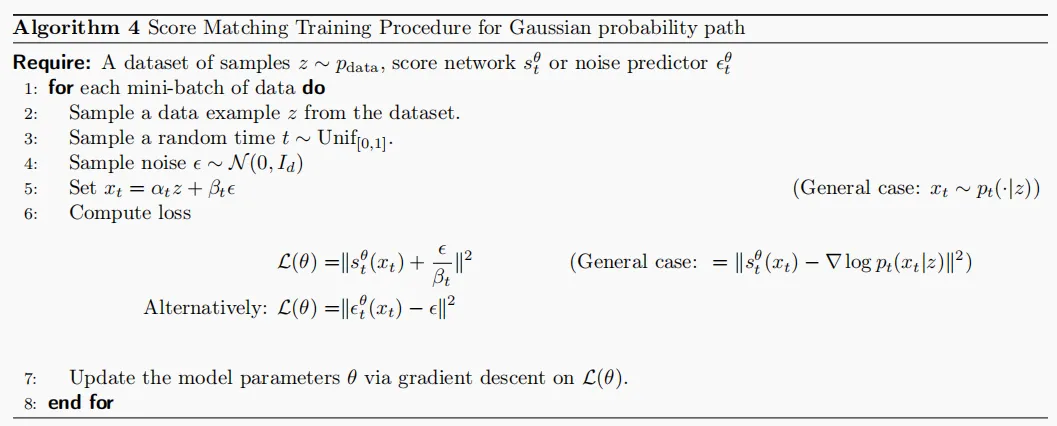
− β t s t θ ( x ) = ϵ t θ ( x ) ⇒ L DDPM ( θ ) = E t ∼ Unif , z ∼ p data , ϵ ∼ N ( 0 , I d ) [ ∥ ϵ t θ ( α t z + β t ϵ ) − ϵ ∥ 2 ] -\beta_t s_t^\theta(x) = \epsilon_t^\theta(x) \quad \Rightarrow \quad \mathcal{L}_{\text{DDPM}}(\theta) = \mathbb{E}_{t \sim \text{Unif}, z \sim p_{\text{data}}, \epsilon \sim \mathcal{N}(0, I_d)}\left[\left\|\epsilon_t^\theta(\alpha_t z + \beta_t \epsilon) - \epsilon\right\|^2\right] − β t s t θ ( x ) = ϵ t θ ( x ) ⇒ L DDPM ( θ ) = E t ∼ Unif , z ∼ p data , ϵ ∼ N ( 0 , I d ) [ ϵ t θ ( α t z + β t ϵ ) − ϵ 2 ] 其训练过程如下所示
此外,对于Gaussian Probability Paths,vector field和score可以相互转化,即
u t target ( x ∣ z ) = ( β t 2 α ˙ t α t − β ˙ t β t ) ∇ log p t ( x ∣ z ) + α ˙ t α t x u t target ( x ) = ( β t 2 α ˙ t α t − β ˙ t β t ) ∇ log p t ( x ) + α ˙ t α t x u_t^{\text{target}}(x|z) = \left( \beta_t^2 \frac{\dot{\alpha}_t}{\alpha_t} - \dot{\beta}_t \beta_t \right) \nabla \log p_t(x|z) + \frac{\dot{\alpha}_t}{\alpha_t} x \\
u_t^{\text{target}}(x) = \left( \beta_t^2 \frac{\dot{\alpha}_t}{\alpha_t} - \dot{\beta}_t \beta_t \right) \nabla \log p_t(x) + \frac{\dot{\alpha}_t}{\alpha_t} x u t target ( x ∣ z ) = ( β t 2 α t α ˙ t − β ˙ t β t ) ∇ log p t ( x ∣ z ) + α t α ˙ t x u t target ( x ) = ( β t 2 α t α ˙ t − β ˙ t β t ) ∇ log p t ( x ) + α t α ˙ t x
proof
u t target ( x ∣ z ) = ( α ˙ t − β ˙ t β t α t ) z + β ˙ t β t x = ( i ) ( β t 2 α ˙ t α t − β ˙ t β t ) ( α t z − x β t 2 ) + α ˙ t α t x = ( β t 2 α ˙ t α t − β ˙ t β t ) ∇ log p t ( x ∣ z ) + α ˙ t α t x u_t^{\text{target}}(x|z) = \left( \dot{\alpha}_t - \frac{\dot{\beta}_t}{\beta_t} \alpha_t \right) z + \frac{\dot{\beta}_t}{\beta_t} x
\stackrel{(i)}{=} \left( \beta_t^2 \frac{\dot{\alpha}_t}{\alpha_t} - \dot{\beta}_t \beta_t \right) \left( \frac{\alpha_t z - x}{\beta_t^2} \right) + \frac{\dot{\alpha}_t}{\alpha_t} x
= \left( \beta_t^2 \frac{\dot{\alpha}_t}{\alpha_t} - \dot{\beta}_t \beta_t \right) \nabla \log p_t(x|z) + \frac{\dot{\alpha}_t}{\alpha_t} x u t target ( x ∣ z ) = ( α ˙ t − β t β ˙ t α t ) z + β t β ˙ t x = ( i ) ( β t 2 α t α ˙ t − β ˙ t β t ) ( β t 2 α t z − x ) + α t α ˙ t x = ( β t 2 α t α ˙ t − β ˙ t β t ) ∇ log p t ( x ∣ z ) + α t α ˙ t x u t target ( x ) = ∫ u t target ( x ∣ z ) p t ( x ∣ z ) p data ( z ) p t ( x ) d z = ∫ [ ( β t 2 α ˙ t α t − β ˙ t β t ) ∇ log p t ( x ∣ z ) + α ˙ t α t x ] p t ( x ∣ z ) p data ( z ) p t ( x ) d z = ( i ) ( β t 2 α ˙ t α t − β ˙ t β t ) ∇ log p t ( x ) + α ˙ t α t x \begin{align*}
u_t^{\text{target}}(x) &= \int u_t^{\text{target}}(x|z) \frac{p_t(x|z) p_{\text{data}}(z)}{p_t(x)} \,\mathrm{d}z \\
&= \int \left[ \left( \beta_t^2 \frac{\dot{\alpha}_t}{\alpha_t} - \dot{\beta}_t \beta_t \right) \nabla \log p_t(x|z) + \frac{\dot{\alpha}_t}{\alpha_t} x \right] \frac{p_t(x|z) p_{\text{data}}(z)}{p_t(x)} \,\mathrm{d}z \\
&\stackrel{(i)}{=} \left( \beta_t^2 \frac{\dot{\alpha}_t}{\alpha_t} - \dot{\beta}_t \beta_t \right) \nabla \log p_t(x) + \frac{\dot{\alpha}_t}{\alpha_t} x
\end{align*} u t target ( x ) = ∫ u t target ( x ∣ z ) p t ( x ) p t ( x ∣ z ) p data ( z ) d z = ∫ [ ( β t 2 α t α ˙ t − β ˙ t β t ) ∇ log p t ( x ∣ z ) + α t α ˙ t x ] p t ( x ) p t ( x ∣ z ) p data ( z ) d z = ( i ) ( β t 2 α t α ˙ t − β ˙ t β t ) ∇ log p t ( x ) + α t α ˙ t x
u t θ u_t^\theta u t θ s t θ s^\theta_t s t θ
u t θ ( x ) = ( β t 2 α ˙ t α t − β ˙ t β t ) s t θ ( x ) + α ˙ t α t x u_t^\theta(x) = \left( \beta_t^2 \frac{\dot{\alpha}_t}{\alpha_t} - \dot{\beta}_t \beta_t \right) s_t^\theta(x) + \frac{\dot{\alpha}_t}{\alpha_t} x u t θ ( x ) = ( β t 2 α t α ˙ t − β ˙ t β t ) s t θ ( x ) + α t α ˙ t x s t θ ( x ) = α t u t θ ( x ) − α ˙ t x β t 2 α t − α t β ˙ t β t s_t^\theta(x) = \frac{\alpha_t u_t^\theta(x) - \dot{\alpha}_t x}{\beta_t^2 \alpha_t - \alpha_t \dot{\beta}_t \beta_t} s t θ ( x ) = β t 2 α t − α t β ˙ t β t α t u t θ ( x ) − α ˙ t x 因此对于Gaussian probability paths来说,只需训练u t θ u_t^\theta u t θ s t θ s^\theta_t s t θ 且使用flow matching或者使用score matching的方法均可
最后,对于训练好的s t θ s_t^\theta s t θ
X 0 ∼ p init , d X t = [ ( β t 2 α ˙ t α t − β ˙ t β t + σ t 2 2 ) s t θ ( x ) + α ˙ t α t x ] d t + σ t d W t ⟹ X 1 = p d a t a X_0 \sim p_{\text{init}}, \quad \mathrm{d}X_t = \left[ \left( \beta_t^2 \frac{\dot{\alpha}_t}{\alpha_t} - \dot{\beta}_t \beta_t + \frac{\sigma_t^2}{2} \right) s_t^\theta(x) + \frac{\dot{\alpha}_t}{\alpha_t} x \right] \mathrm{d}t + \sigma_t \mathrm{d}W_t \\
\implies X_1=p_{data} X 0 ∼ p init , d X t = [ ( β t 2 α t α ˙ t − β ˙ t β t + 2 σ t 2 ) s t θ ( x ) + α t α ˙ t x ] d t + σ t d W t ⟹ X 1 = p d a t a Summary#
总的来说,Flow Matching比Score Matching更简洁并且Flow Matching更具有拓展性,可以实现从一个任意初始分布p i n i t p_{init} p ini t p d a t a p_{data} p d a t a
Conditional (Guided) Generation#
在给定条件下进行生成(generate an object conditioned on some additional information ),称之为conditional generation,为了和conditional vector field区分多称为guided generation
用数学语言描述即,对于y ∈ Y y \in \mathcal{Y} y ∈ Y p d a t a ( x ∣ y ) p_{data}(x \mid y) p d a t a ( x ∣ y ) u t θ ( ⋅ ∣ y ) u_t^{\theta}(\cdot \mid y) u t θ ( ⋅ ∣ y )
Neural network: u t θ : R d × Y × [ 0 , 1 ] → R d , ( x , y , t ) ↦ u t θ ( x ∣ y ) Fixed: σ t : [ 0 , 1 ] → [ 0 , ∞ ) , t ↦ σ t \begin{align*}
\text{Neural network: } & u_t^\theta : \mathbb{R}^d \times \mathcal{Y} \times [0, 1] \to \mathbb{R}^d, \quad (x, y, t) \mapsto u_t^\theta(x|y) \\
\text{Fixed: } & \sigma_t : [0, 1] \to [0, \infty), \quad t \mapsto \sigma_t
\end{align*} Neural network: Fixed: u t θ : R d × Y × [ 0 , 1 ] → R d , ( x , y , t ) ↦ u t θ ( x ∣ y ) σ t : [ 0 , 1 ] → [ 0 , ∞ ) , t ↦ σ t 对于给定的y ∈ R d y y \in \mathbb{R}^{d_y} y ∈ R d y
Initialization: X 0 ∼ p init ▹ Initialize with simple distribution Simulation: d X t = u t θ ( X t ∣ y ) d t + σ t d W t ▹ Simulate SDE from t = 0 to t = 1. Goal: X 1 ∼ p data ( ⋅ ∣ y ) ▹ X 1 to be distributed like p data ( ⋅ ∣ y ) \begin{align*}
\text{Initialization:} \quad & X_0 \sim p_{\text{init}} \quad &\triangleright \text{ Initialize with simple distribution} \\
\text{Simulation:} \quad & \mathrm{d}X_t = u_t^\theta(X_t|y)\,\mathrm{d}t + \sigma_t\,\mathrm{d}W_t \quad &\triangleright \text{ Simulate SDE from } t=0 \text{ to } t=1. \\
\text{Goal:} \quad & X_1 \sim p_{\text{data}}(\cdot|y) \quad &\triangleright X_1 \text{ to be distributed like } p_{\text{data}}(\cdot|y)
\end{align*} Initialization: Simulation: Goal: X 0 ∼ p init d X t = u t θ ( X t ∣ y ) d t + σ t d W t X 1 ∼ p data ( ⋅ ∣ y ) ▹ Initialize with simple distribution ▹ Simulate SDE from t = 0 to t = 1. ▹ X 1 to be distributed like p data ( ⋅ ∣ y ) 上述在σ t = 0 \sigma_t=0 σ t = 0
Guided Models#
Guided Flow Models的训练损失(优化目标,或者说guided conditional flow matching objective)很容的得到,如下所示
L CFM guided ( θ ) = E ( z , y ) ∼ p data ( z , y ) , t ∼ Unif ( 0 , 1 ) , x ∼ p t ( ⋅ ∣ z ) [ ∥ u t θ ( x ∣ y ) − u t target ( x ∣ z ) ∥ 2 ] \begin{align*}
\mathcal{L}_{\text{CFM}}^{\text{guided}}(\theta) &= \mathbb{E}_{(z,y) \sim p_{\text{data}}(z,y),\, t \sim \text{Unif}(0,1),\, x \sim p_t(\cdot|z)} \left[ \left\| u_t^\theta(x|y) - u_t^{\text{target}}(x|z) \right\|^2 \right]
\end{align*} L CFM guided ( θ ) = E ( z , y ) ∼ p data ( z , y ) , t ∼ Unif ( 0 , 1 ) , x ∼ p t ( ⋅ ∣ z ) [ u t θ ( x ∣ y ) − u t target ( x ∣ z ) 2 ] 同样的,对于Guided Diffusion Models,有guided conditional score matching objective如下
L CSM guided ( θ ) = E □ [ ∥ s t θ ( x ∣ y ) − ∇ log p t ( x ∣ z ) ∥ 2 ] □ = ( z , y ) ∼ p data ( z , y ) , t ∼ Unif ( 0 , 1 ) , x ∼ p t ( ⋅ ∣ z ) \begin{align*}
\mathcal{L}_{\text{CSM}}^{\text{guided}}(\theta) &= \mathbb{E}_{\square} \left[ \| s_t^\theta(x|y) - \nabla \log p_t(x|z) \|^2 \right] \\
\square &= (z, y) \sim p_{\text{data}}(z, y),\ t \sim \text{Unif}(0,1),\ x \sim p_t(\cdot|z)
\end{align*} L CSM guided ( θ ) □ = E □ [ ∥ s t θ ( x ∣ y ) − ∇ log p t ( x ∣ z ) ∥ 2 ] = ( z , y ) ∼ p data ( z , y ) , t ∼ Unif ( 0 , 1 ) , x ∼ p t ( ⋅ ∣ z ) 虽然理论上上述以及足够生成标签y y y y y y y y y
Classifier-Free Guidance#
对于Flow Models,以Gaussian probability paths为例
u t target ( x ∣ y ) = a t x + b t ∇ log p t ( x ∣ y ) \begin{align*}
u_t^{\text{target}}(x|y) = a_t x + b_t \nabla \log p_t(x|y)
\end{align*} u t target ( x ∣ y ) = a t x + b t ∇ log p t ( x ∣ y ) 其中
( a t , b t ) = ( α ˙ t α t , α ˙ t β t 2 − β ˙ t β t α t α t ) \begin{align*}
(a_t, b_t) = \left( \frac{\dot{\alpha}_t}{\alpha_t}, \frac{\dot{\alpha}_t \beta_t^2 - \dot{\beta}_t \beta_t \alpha_t}{\alpha_t} \right)
\end{align*} ( a t , b t ) = ( α t α ˙ t , α t α ˙ t β t 2 − β ˙ t β t α t ) 又
∇ log p t ( x ∣ y ) = ∇ log ( p t ( x ) p t ( y ∣ x ) p t ( y ) ) = ∇ log p t ( x ) + ∇ log p t ( y ∣ x ) \begin{align*}
\nabla \log p_t(x|y) = \nabla \log \left( \frac{p_t(x) p_t(y|x)}{p_t(y)} \right) = \nabla \log p_t(x) + \nabla \log p_t(y|x)
\end{align*} ∇ log p t ( x ∣ y ) = ∇ log ( p t ( y ) p t ( x ) p t ( y ∣ x ) ) = ∇ log p t ( x ) + ∇ log p t ( y ∣ x ) 则
u t target ( x ∣ y ) = a t x + b t ( ∇ log p t ( x ) + ∇ log p t ( y ∣ x ) ) = u t target ( x ) + b t ∇ log p t ( y ∣ x ) \begin{align*}
u_t^{\text{target}}(x|y) = a_t x + b_t (\nabla \log p_t(x) + \nabla \log p_t(y|x)) = u_t^{\text{target}}(x) + b_t \nabla \log p_t(y|x)
\end{align*} u t target ( x ∣ y ) = a t x + b t ( ∇ log p t ( x ) + ∇ log p t ( y ∣ x )) = u t target ( x ) + b t ∇ log p t ( y ∣ x ) 可以看出,guided vector field是由unguided vector field和guided score相加得到,一种很自然的想法是对guided score进行加权,得到
u ~ t ( x ∣ y ) = u t target ( x ) + w b t ∇ log p t ( y ∣ x ) \begin{align*}
\tilde{u}_t(x|y) = u_t^{\text{target}}(x) + wb_t \nabla \log p_t(y|x)
\end{align*} u ~ t ( x ∣ y ) = u t target ( x ) + w b t ∇ log p t ( y ∣ x ) 其中guided score可以看作是噪声类别分类器,早期的工作确实使用这样的方法实现,但是进一步对guided score进行分析得到如下:
u ~ t ( x ∣ y ) = u t target ( x ) + w b ∇ log p t ( y ∣ x ) = u t target ( x ) + w b ( ∇ log p t ( x ∣ y ) − ∇ log p t ( x ) ) = u t target ( x ) − ( w a x + w b ∇ log p t ( x ) ) + ( w a x + w b ∇ log p t ( x ∣ y ) ) = ( 1 − w ) u t target ( x ) + w u t target ( x ∣ y ) . \begin{align*}
\tilde{u}_t(x|y) &= u_t^{\text{target}}(x) + w_b \nabla \log p_t(y|x) \\
&= u_t^{\text{target}}(x) + w_b (\nabla \log p_t(x|y) - \nabla \log p_t(x)) \\
&= u_t^{\text{target}}(x) - (w_a x + w_b \nabla \log p_t(x)) + (w_a x + w_b \nabla \log p_t(x|y)) \\
&= (1 - w) u_t^{\text{target}}(x) + w u_t^{\text{target}}(x|y).
\end{align*} u ~ t ( x ∣ y ) = u t target ( x ) + w b ∇ log p t ( y ∣ x ) = u t target ( x ) + w b ( ∇ log p t ( x ∣ y ) − ∇ log p t ( x )) = u t target ( x ) − ( w a x + w b ∇ log p t ( x )) + ( w a x + w b ∇ log p t ( x ∣ y )) = ( 1 − w ) u t target ( x ) + w u t target ( x ∣ y ) . 即u ~ t ( x ∣ y ) \tilde{u}_t(x|y) u ~ t ( x ∣ y ) y = ∅ y = \varnothing y = ∅ η \eta η u t target ( x ∣ ∅ ) u_t^{\text{target}}(x|\varnothing) u t target ( x ∣ ∅ ) u t target ( x ) u_t^{\text{target}}(x) u t target ( x )
L CFM CFG ( θ ) = E □ [ ∥ u t θ ( x ∣ y ) − u t target ( x ∣ z ) ∥ 2 ] □ = ( z , y ) ∼ p data ( z , y ) , t ∼ Unif ( 0 , 1 ) , x ∼ p t ( ⋅ ∣ z ) , replace y = ∅ with prob. η \begin{align*}
\mathcal{L}_{\text{CFM}}^{\text{CFG}}(\theta) &= \mathbb{E}_{\square} \left[ \| u_t^\theta(x|y) - u_t^{\text{target}}(x|z) \|^2 \right] \\
\square &= (z, y) \sim p_{\text{data}}(z, y),\ t \sim \text{Unif}(0,1),\ x \sim p_t(\cdot|z),\ \text{replace } y = \varnothing \text{ with prob. } \eta
\end{align*} L CFM CFG ( θ ) □ = E □ [ ∥ u t θ ( x ∣ y ) − u t target ( x ∣ z ) ∥ 2 ] = ( z , y ) ∼ p data ( z , y ) , t ∼ Unif ( 0 , 1 ) , x ∼ p t ( ⋅ ∣ z ) , replace y = ∅ with prob. η 对于Diffusion Models,s ~ t ( x ∣ y ) \tilde{s}_t(x|y) s ~ t ( x ∣ y )
s ~ t ( x ∣ y ) = ∇ log p t ( x ) + w ∇ log p t ( y ∣ x ) = ∇ log p t ( x ) + w ( ∇ log p t ( x ∣ y ) − ∇ log p t ( x ) ) = ( 1 − w ) ∇ log p t ( x ) + w ∇ log p t ( x ∣ y ) = ( 1 − w ) ∇ log p t ( x ∣ ∅ ) + w ∇ log p t ( x ∣ y ) \begin{align*}
\tilde{s}_t(x|y) &= \nabla \log p_t(x) + w \nabla \log p_t(y|x) \\
&= \nabla \log p_t(x) + w (\nabla \log p_t(x|y) - \nabla \log p_t(x)) \\
&= (1 - w) \nabla \log p_t(x) + w \nabla \log p_t(x|y) \\
&= (1 - w) \nabla \log p_t(x|\varnothing) + w \nabla \log p_t(x|y)
\end{align*} s ~ t ( x ∣ y ) = ∇ log p t ( x ) + w ∇ log p t ( y ∣ x ) = ∇ log p t ( x ) + w ( ∇ log p t ( x ∣ y ) − ∇ log p t ( x )) = ( 1 − w ) ∇ log p t ( x ) + w ∇ log p t ( x ∣ y ) = ( 1 − w ) ∇ log p t ( x ∣ ∅ ) + w ∇ log p t ( x ∣ y ) training objective如下
L CSM CFG ( θ ) = E □ [ ∥ s t θ ( x ∣ ( 1 − ξ ) y + ξ ∅ ) − ∇ log p t ( x ∣ z ) ∥ 2 ] □ = ( z , y ) ∼ p data ( z , y ) , t ∼ Unif ( 0 , 1 ) , x ∼ p t ( ⋅ ∣ z ) , replace y = ∅ with prob. η \begin{align*}
\mathcal{L}_{\text{CSM}}^{\text{CFG}}(\theta) &= \mathbb{E}_{\square} \left[ \| s_t^\theta(x|(1 - \xi)y + \xi \varnothing) - \nabla \log p_t(x|z) \|^2 \right] \\
\square &= (z, y) \sim p_{\text{data}}(z, y),\ t \sim \text{Unif}(0,1),\ x \sim p_t(\cdot|z),\ \text{replace } y = \varnothing \text{ with prob. } \eta
\end{align*} L CSM CFG ( θ ) □ = E □ [ ∥ s t θ ( x ∣ ( 1 − ξ ) y + ξ ∅ ) − ∇ log p t ( x ∣ z ) ∥ 2 ] = ( z , y ) ∼ p data ( z , y ) , t ∼ Unif ( 0 , 1 ) , x ∼ p t ( ⋅ ∣ z ) , replace y = ∅ with prob. η 训练时,我们通常也可同时优化s t θ ( x ∣ y ) {s}_t^\theta(x|y) s t θ ( x ∣ y ) u t θ ( x ∣ y ) {u}_t^\theta(x|y) u t θ ( x ∣ y )
s ~ t θ ( x ∣ y ) = ( 1 − w ) s t θ ( x ∣ ∅ ) + w s t θ ( x ∣ y ) , u ~ t θ ( x ∣ y ) = ( 1 − w ) u t θ ( x ∣ ∅ ) + w u t θ ( x ∣ y ) . \begin{align*}
\tilde{s}_t^\theta(x|y) &= (1 - w) s_t^\theta(x|\varnothing) + w s_t^\theta(x|y), \\
\tilde{u}_t^\theta(x|y) &= (1 - w) u_t^\theta(x|\varnothing) + w u_t^\theta(x|y).
\end{align*} s ~ t θ ( x ∣ y ) u ~ t θ ( x ∣ y ) = ( 1 − w ) s t θ ( x ∣ ∅ ) + w s t θ ( x ∣ y ) , = ( 1 − w ) u t θ ( x ∣ ∅ ) + w u t θ ( x ∣ y ) . 采样时,有
d X t = [ u ~ t θ ( X t ∣ y ) + σ t 2 2 s t θ ( X t ∣ y ) ] d t + σ t d W t \mathrm{d}X_t = \left[ \tilde{u}_t^\theta(X_t|y) + \frac{\sigma_t^2}{2} s_t^\theta(X_t|y) \right] \mathrm{d}t + \sigma_t \mathrm{d}W_t d X t = [ u ~ t θ ( X t ∣ y ) + 2 σ t 2 s t θ ( X t ∣ y ) ] d t + σ t d W t Network architectures#
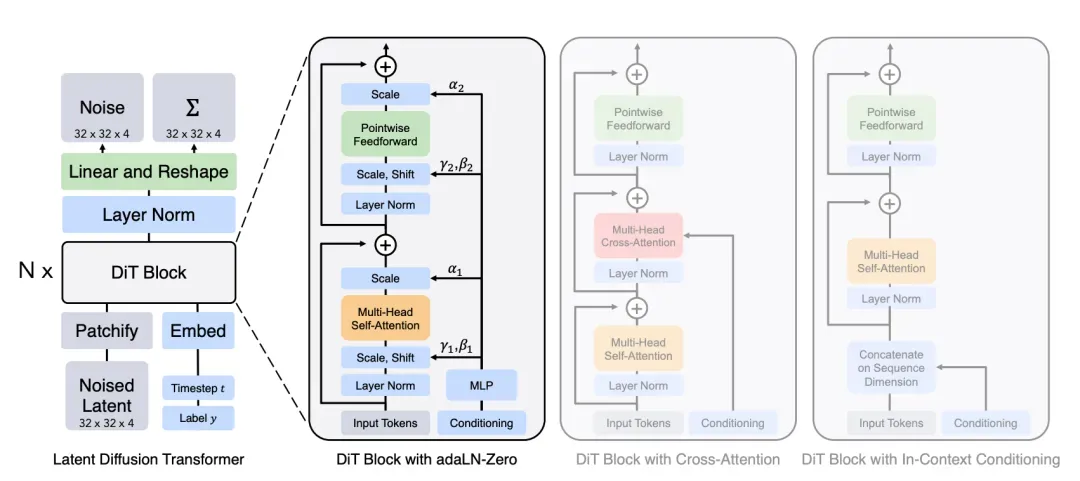
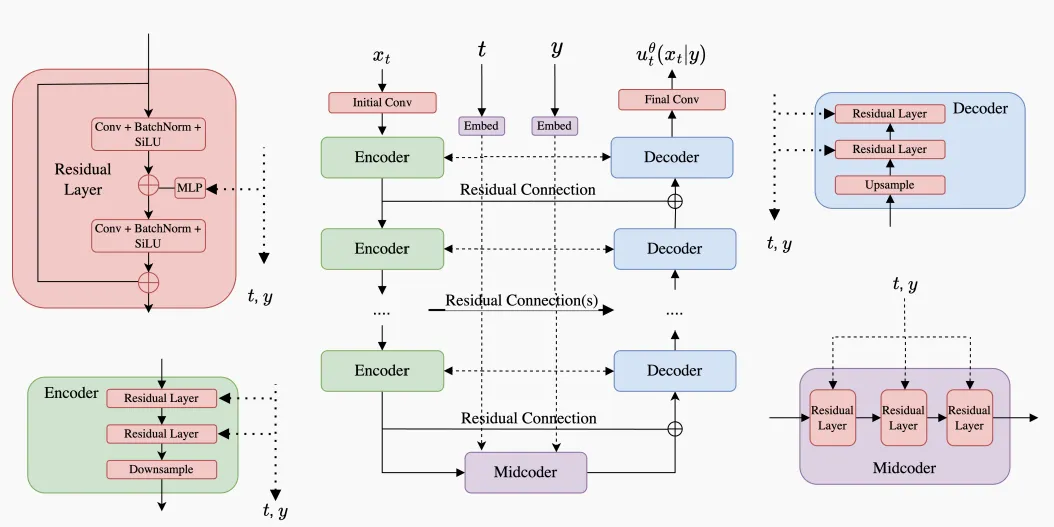
网络模型的设计随建模数据的复杂程度各有差别,但都需满足
Neural network: u t θ : R d × Y × [ 0 , 1 ] → R d , ( x , y , t ) ↦ u t θ ( x ∣ y ) \text{Neural network: } u_t^\theta : \mathbb{R}^d \times \mathcal{Y} \times [0, 1] \to \mathbb{R}^d, \quad (x, y, t) \mapsto u_t^\theta(x|y) Neural network: u t θ : R d × Y × [ 0 , 1 ] → R d , ( x , y , t ) ↦ u t θ ( x ∣ y ) U-Nets#
References#
[1] Peter Holderrieth and Ezra Erives.An Introduction to Flow Matching and Diffusion Models[EB/OL].https://arxiv.org/abs/2506.02070,2025 ↗ .